ping 1.1.1.1 不通,先查哪一跳:网络排查的一般思路
ping 超时只是一个结果。先画出请求和回包两条路,再用分段二分缩小范围,最后用选路、转发、改写、命中、回程五个检查点逐跳取证。
本文目录
ping 1.1.1.1 超时。
换了个网络,还是超时;换了 DNS、重启了路由器,依然是超时。到这一步,多数人开始猜:是不是运营商的问题?是不是该换个设备试试?
先说结论:ping 超时只是一个结果。它可能是 ICMP 被禁、端口没开,也可能是云上的安全组没放行。它不指向任何一个原因。
真正能往下走的前提,是把"不通"翻译成一条可以逐条回答的路径。
先选对探测,再看结果
“不通"至少有三种形态:ping 超时、连不上端口、名字解析失败。它们落在不同的层次上,用同一条命令去测,只会得到互相矛盾的结论。
先说 ping 的边界。它只做一件事:发一个 ICMP 回声请求,等回显。它能支持的结论只有一条——这个地址的 ICMP 往返成功了。往外推一步就都是错的。
ping 不通,不代表机器坏了。 很多网络在入口直接丢掉 ICMP,云主机、企业出口、部分家用路由器都这样。目标不回你 ping,HTTPS 照样正常,这时候你去修网络是白修。
ping 通,也不代表服务能访问。 ping 没有验证端口,没有验证 TLS 握手,没有验证应用层的任何一件事。反过来也一样:业务连不上时 ping 可能依然通,因为它们经过的规则根本不是同一套。
ping 只覆盖一段路。 不同的探测覆盖的路段并不相同。Tailscale 的文档就写明,tailscale ping --tsmp 会经过 WireGuard,但不经过两端操作系统的协议栈;它和普通系统 ping 覆盖的环节并不一样。Tailscale CLI 的 ping 说明 这不是说本例用了某个具体软件,而是提醒你:换一条命令,就可能换了被覆盖的那一段路。
所以动手之前,先把问题分层,每层用对应的探测:
| 层次 | 要回答的问题 | 该用的探测 |
|---|---|---|
| 链路与地址 | 包该从哪个接口出去?邻居解析得到吗? | ip route get、ip addr、ARP 表 |
| 名字 | 域名解析对不对? | dig,分别问递归服务器和权威服务器 |
| 端口 | 目标端口接不接受连接? | nc -vz <主机> <端口>、curl -v、openssl s_client |
| 应用 | 服务本身是否正常? | 真实业务请求 + 服务端日志 |
| 策略 | 包在到达主机之前被谁丢的? | 云上安全组、网络 ACL、上游防火墙 |
最后一层最容易被漏掉。跑在云主机上的服务连不上时,最常见的原因之一就是安全组:入站规则没放行这个端口,包在到达主机之前就被丢掉了。这种情况下你在主机上抓包会看到什么都没有——没有 SYN,也没有 SYN-ACK,只有沉默。这时该去控制台看规则,而不是在主机上反复重试。
还有一条纪律:不要用一条探测去覆盖多个判断。“ping 通了,所以网络没问题”,是排查里最常见的错误结论之一。它只说明 ICMP 那一段是通的。
先画出一条完整的路
把路径写出来,比任何猜测都便宜。
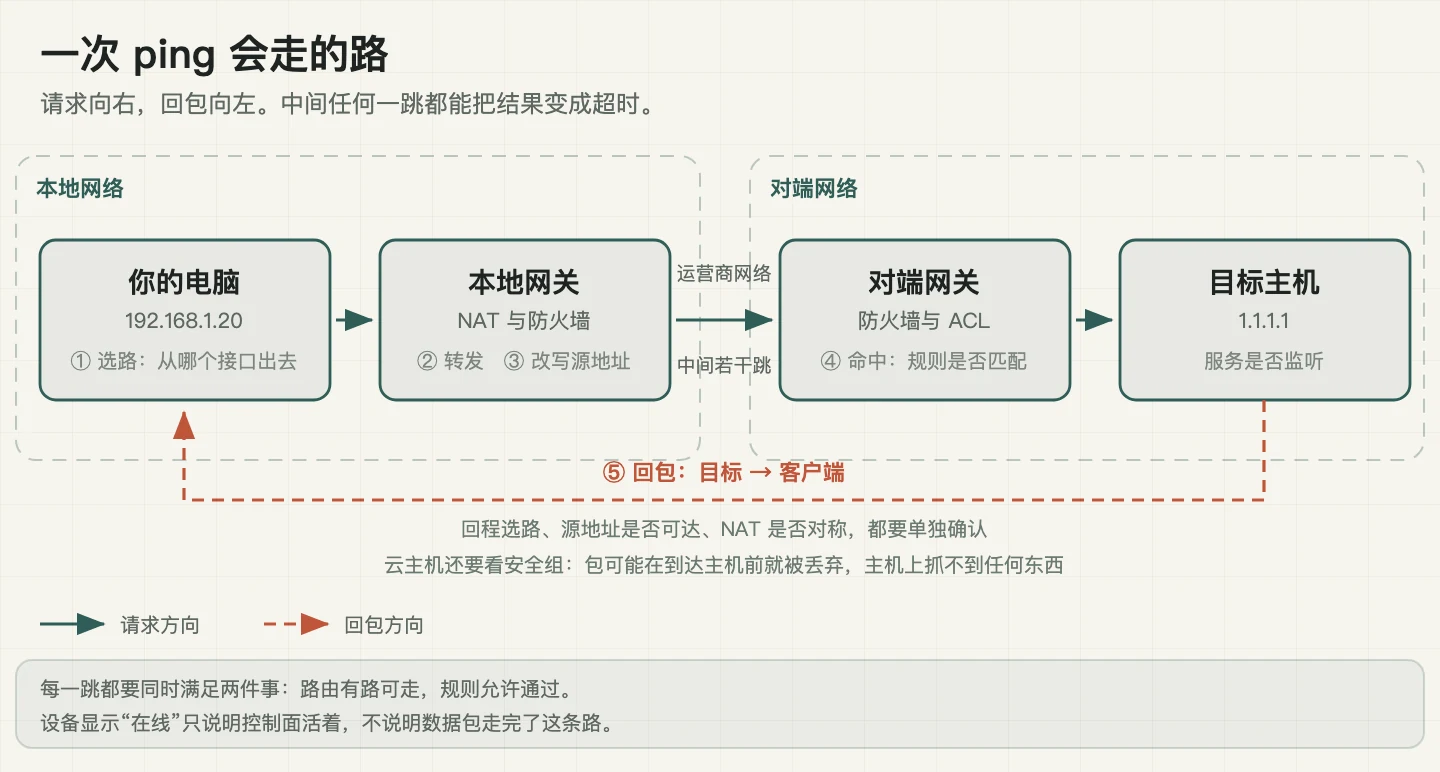
一条最常见的路径可以拆成五段:
| 路段 | 这一段能问的问题 | 可用的检查手段 |
|---|---|---|
| 本机 | 包打算从哪个接口出去? | 路由表、策略路由、ip route get |
| 本地网关 | 它会收下并转交吗?会不会改写源地址? | 网关状态、NAT/防火墙规则、抓包 |
| 运营商网络 | 中间有没有丢包或限速? | 多点探测、连续观测而非单次 |
| 对端网关 | 规则是否真的匹配这条流量? | 规则顺序、计数器、抓包 |
| 云上安全组 | 包在到达主机前被丢了吗? | 控制台入站规则、端口范围、网络 ACL |
| 目标主机 | 服务是否在监听、是否回包? | 端口状态、日志、服务端视角 |
这里最容易被忽略的是:请求方向和回包方向是两条不同的路。请求能到,不代表回包能回来;回包能回来,也不代表请求走到了目标。ping 超时只说明"往返中至少有一段没走通”,它不能告诉你是哪一段。
因此排查时要尽量对照同一次请求的记录:源地址、目标地址、探测命令、发生时间。拿另一条流量的计数,去替这次请求作证,是最常见也最隐蔽的错误。
缩小范围:三个判断切掉大半
路径画出来之后,不必逐点猜。先做能明确证伪的判断,把范围切小,再逐跳取证。
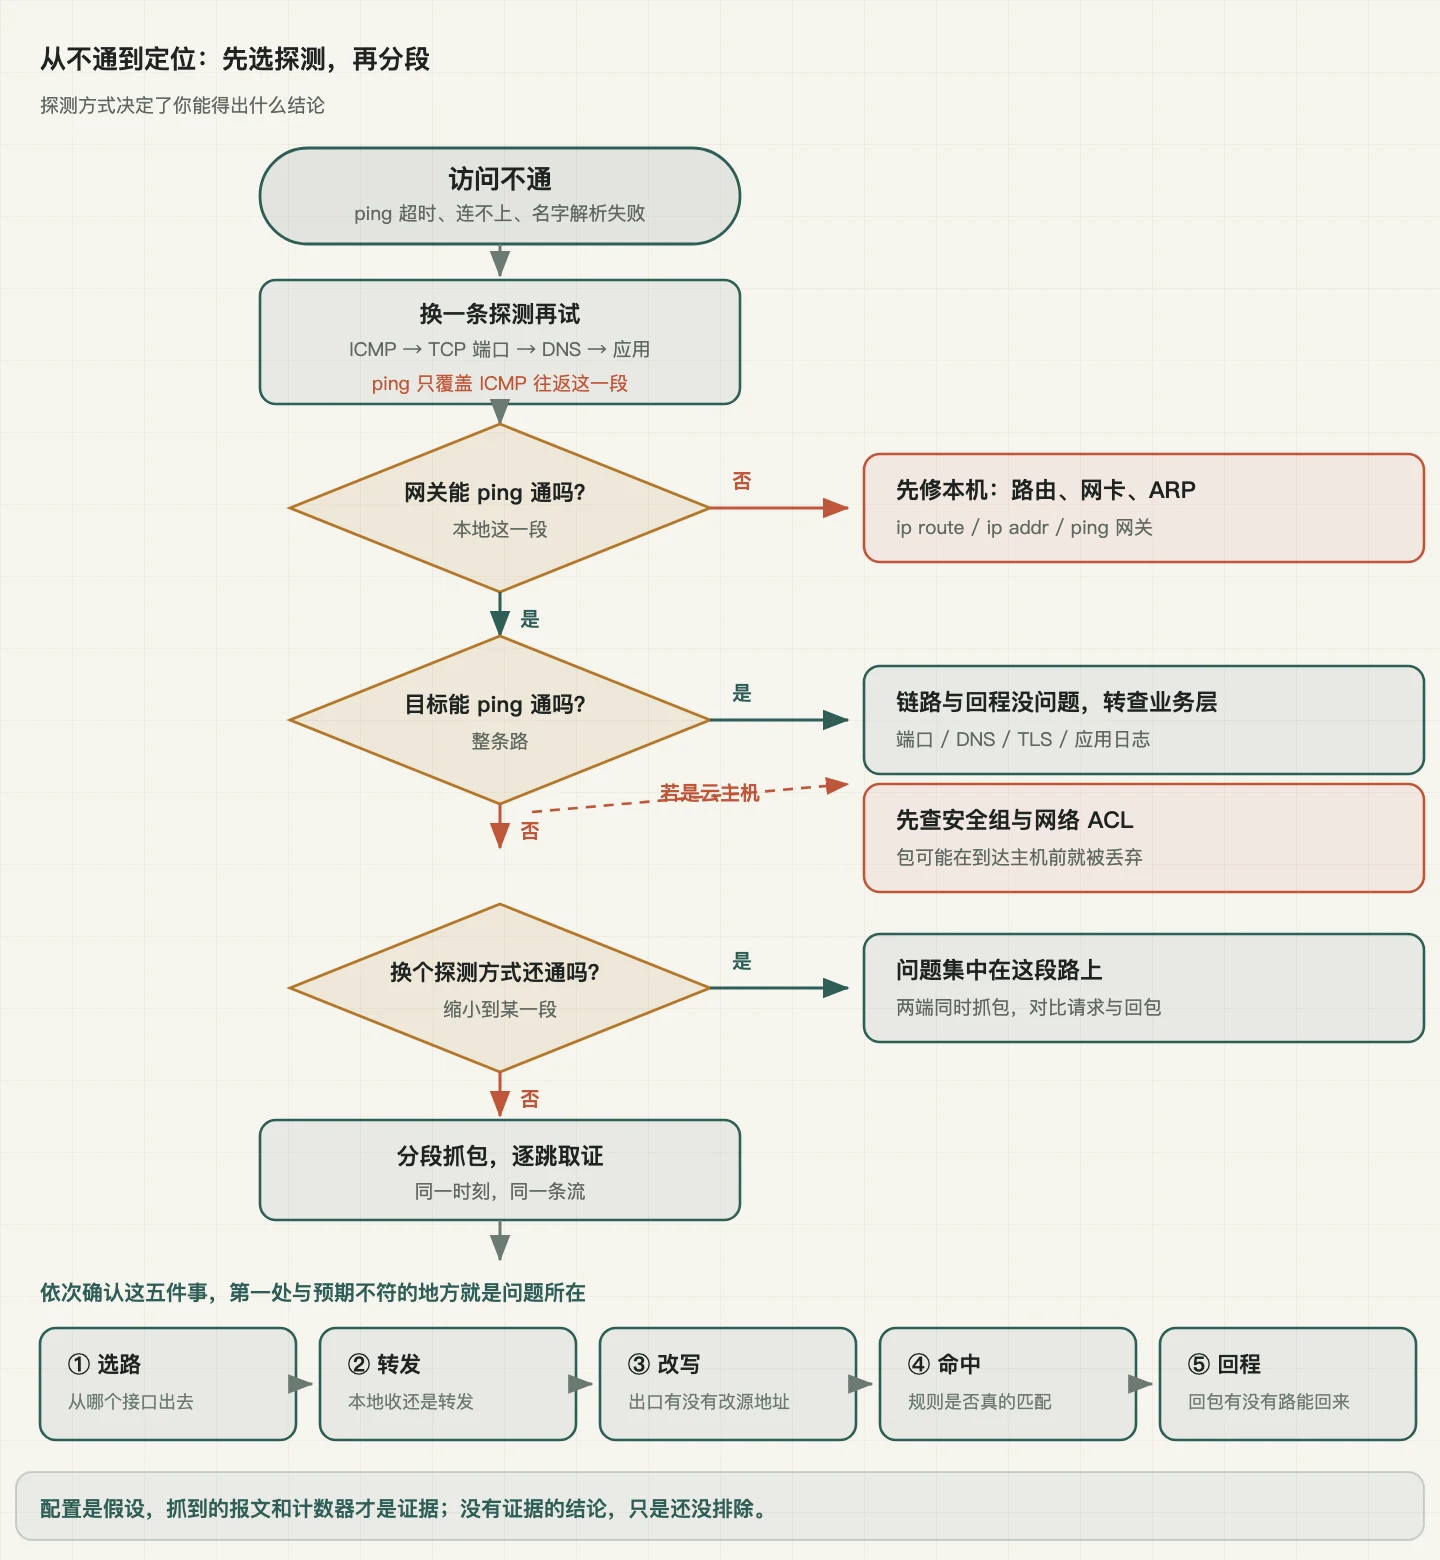
动手前先换一条探测。同一个目标,ping 不通但 TCP 端口能连上,说明被拦的是 ICMP 那一段,范围立刻缩到主机之外;两个都不通,才需要继续往下分。
这三个判断能把范围切掉一大半。
网关能 ping 通吗? 不通,问题大概率在本机:路由表里有没有这条目的的路由、网卡状态与地址对不对、ARP 是否解析得到。这一段全在你手上,改完立刻能看到效果。
网关通,目标不通? 这时候链路本身是好的,问题在中间、回程,或者根本没到主机——如果目标在云上,先去控制台看安全组和网络 ACL,再回到主机上看。这一段经常被跳过,因为"我在机器上抓不到包"很容易被误读成"网络没问题"。
目标通了,但服务仍然连不上? 说明链路与回程都没问题,问题在业务层:端口没开、DNS 解析错、TLS 证书不对,或者应用自己出错了。这时候该用的探测是 TCP 连接和真实请求,不是 ping。
换目标或换探测还通? 说明问题集中在这条路上,接下来就在两端同时抓包,对比请求和回包。都不通? 说明问题更靠底层,或者是两端的共同前提出了问题,这时才进入逐跳取证。
每一步都要有判据,而不是"试试看"。判据是"这条命令的哪个字段能证明什么":路由查询返回的出口接口和下一跳,链上的包计数,抓包里出现的源地址,以及它们是否属于你正在排查的那一次请求。
顺便说几个常见的错误动作:用 ping 的结果去判断业务是否恢复(它只能说明 ICMP 通);不通就换 DNS(DNS 只影响名字解析,不影响拿到 IP 之后的连通性);看到 traceroute 第一跳丢包就换网卡(第一跳丢包可能只是中间设备不回探测包);把"重启一下"当作排查步骤(重启能恢复,不代表你知道它为什么坏)。
逐跳取证:五个通用检查点
范围缩小到某一段之后,按同样的顺序把这一段问清楚。下面五个检查点在绝大多数网络里都成立,只是命令和路径要看具体系统。
一、选路:包到底从哪个接口出去
发包前,内核先查路由表:目的地址段、出口网卡、下一跳。同一个前缀可能同时存在于多张表里,由策略路由决定查哪张。
ip rule show
ip route show table all
ip route get <目标地址>
ip rule show 回答"有没有按 priority 和 selector 选择其他表";ip route show table all 用来核对各表中的前缀、metric 与出口;ip route get 直接给出给定条件下的本机选路结果。
按正在排查的那一次请求补上条件,查询才有意义:转发包要带上实际的源地址和入接口,已知路由决策时的标记就带上标记。
判据很明确:查出来的出口和下一跳,与你设计中的路径一致,就说明选路这一跳没问题;不一致,就要先解释这个结果,再往下一跳走。
二、转发:这一跳是本地收,还是替别人转
包到达一台主机后,先判断它是不是给自己的。最终地址是自己 IP 的走 INPUT,不是自己 IP 的走 FORWARD——目的地是本机的流量,规则在 INPUT 链上生效;目的地是另一台机器的流量,规则在 FORWARD 链上生效,两条链互不相干。
所以"这台机器能响应自己的服务"和"它允许把流量转给别处"是两个问题,需要分别确认:转发是否启用、去目标的路由是否有效、FORWARD 链上的规则是否允许这类流量。
计数只能作辅助判断,它能说明这条链上过去一段时间有多少包,却不能替你确认这次请求是否经过了它。
三、改写:出口有没有换掉源地址
经过网关时,源地址经常被改写。改写本身是设计的一部分:把内网地址换成公网地址,回包才能找到回来的路。
确认的办法是抓包。在出口和入口各看一眼同一个包,源地址是否变了、变没变是否符合设计,一眼就能看出来。
如果源地址没有被改写,而目标又不在你的回程可达范围内,那么回包就会走到默认网关去——能不能被转发、会不会被丢弃,由对方的策略决定。查回程路由,比盯着请求看更有用。
四、命中:规则在,不等于规则命中
包走到了转发链上,SNAT 仍然可能没有发生。这类问题的关键往往是"规则确实存在,但匹配条件没成立"。
Linux 上最容易被忽略的条件是 packet mark:它是内核在处理数据包时关联的标记,可供规则匹配和策略路由使用,本身并不是写进 IP 报文、随包发出去的字段,普通抓包看不到它。iptables 扩展手册中的 MARK
一个典型的冲突长这样:
包从虚拟网卡进来
  → FORWARD 链 → 隧道软件打上标记(done)
  → mangle POSTROUTING → 策略软件清掉那几位标记(gone)
  → nat POSTROUTING → 隧道软件查标记 → 没了 → 不改源地址(broken)
要验证这个假设,需要把三件事对上:哪条规则写入标记、哪条规则清除标记、它们分别在哪个表哪个链上。
iptables -t mangle -nvxL POSTROUTING --line-numbers
iptables -t nat -nvxL POSTROUTING --line-numbers
这两条给出规则位置和精确的包/字节计数,用来对照标记的写入条件、清除条件和 NAT 的匹配条件。注意 nat 表的计数只能解释为新连接首包的证据,不能逐包证明既有连接重新走过 NAT。
五、回程:回包有没有路能回来
请求和回包走两条路,这条路的毛病不会出现在请求侧。
要确认三件事:目标回包时会发给谁(按目标所在网段的回程路由算,不按你的想象算)、这条回程有没有被任何一环拦掉(对端的防火墙、自己的反向过滤、运营商侧的处理)、以及 NAT 的映射是否对称(有些场景下回包会被交给默认网关,而不是回到建立连接的机器)。
排查回程时,最省事的做法仍然是在目标侧抓包:回包到底有没有发出来、源地址是不是你期望的那个。没有发出来,问题在目标或它的网关;发出来了但回不去,问题在你的回程路由或 NAT 映射。
证据能支持什么,不能支持什么
排障里最贵的错误不是判断错,而是用不够格的证据支撑判断。
有三条原则值得反复拿出来对照。
每一跳都要同时有路和许可。 路由决定包往哪走,规则决定包能不能过。某一段正常,只能说明范围缩小了,不能替下一段背书。
请求和回包是两条路。 往返失败只说明其中至少一条断了。
配置是假设,报文和计数器才是证据。 “我看到一条 NAT 规则"不等于"这个包命中了它”;“计数器涨了"不等于"涨的是这次请求”。
还有两个时间陷阱。抓包是某一时刻的快照,计数器是一段时间的累计,两者要能对上同一条流量、同一个时间窗,才有资格放在一起解释。一次成功也不代表下一次成功:连接状态、NAT 映射表、路由缓存和超时重传,都会让同一个命令前后两次结果不同。涉及 NAT 的场景,复测时还要确认用的是新连接。
什么时候可以说找到了原因
判据只有一条:你能指出第一个与预期不同的跳点,并且有直接证据支持它。
在上面的框架里,这个跳点可能是选路选错出口、转发链没放行、源地址没按设计改写、规则没命中,或者回包没有路可回。哪一个都行,但要能指名,也要说得出证据是什么。
修正配置之后,用同样的源、同样的目标、同样的探测方式再测一次,确认差异来自这次修改,而不是一次侥幸。涉及 NAT 时,还要确认测试用的是新连接。
真正有价值的排障记录,是把被否定的假设也写下来:选路正常,暂时排除出口错误;请求已发出,转向回程。下一次遇到相似现象,别人才能复查你的判断,而不是照着最后一条命令重复改一遍。
把"不通"翻译成问题清单
网络排查之所以让人焦虑,是因为它常常从一句"网不通"开始——那不是一个可以回答的问题,只是一种感受。
把感受翻译成路径之后,它就变成了几个可以逐条回答、逐条取证的问题:包打算从哪出去?这一跳收不收?源地址有没有被改?规则命中没有?回包有没有路?
网通的定义,不是设备显示在线,也不是一次 ping 成功,而是这条路上每一个点都拿到了许可。